
Zombie Rescue Service
Что такое Zombie Job?
Zombie - это задание, которое выполнялось, когда воркер упал, был убит или потерял connectivity. Задание навсегда застревает в Processing: оно никогда не завершится, но система не знает, что оно мертво.
Timeline:
─────────────────────────────────────────────
  t=0     Worker fetches Job-42, starts processing
  t=5s    Worker updates heartbeat → HeartbeatUtc = t=5s
  t=10s   Worker updates heartbeat → HeartbeatUtc = t=10s
  t=12s   ⚡ WORKER CRASHES (OOM, server restart, k8s pod eviction)
  t=15s   No heartbeat update...
  t=20s   No heartbeat update...
  t=600s  Job-42 has been "Processing" for 10 minutes with no heartbeat
          → It's a ZOMBIE
Без вмешательства это задание оставалось бы в Processing бесконечно, блокируя slot очереди в Bulkhead mode и никогда не завершаясь.
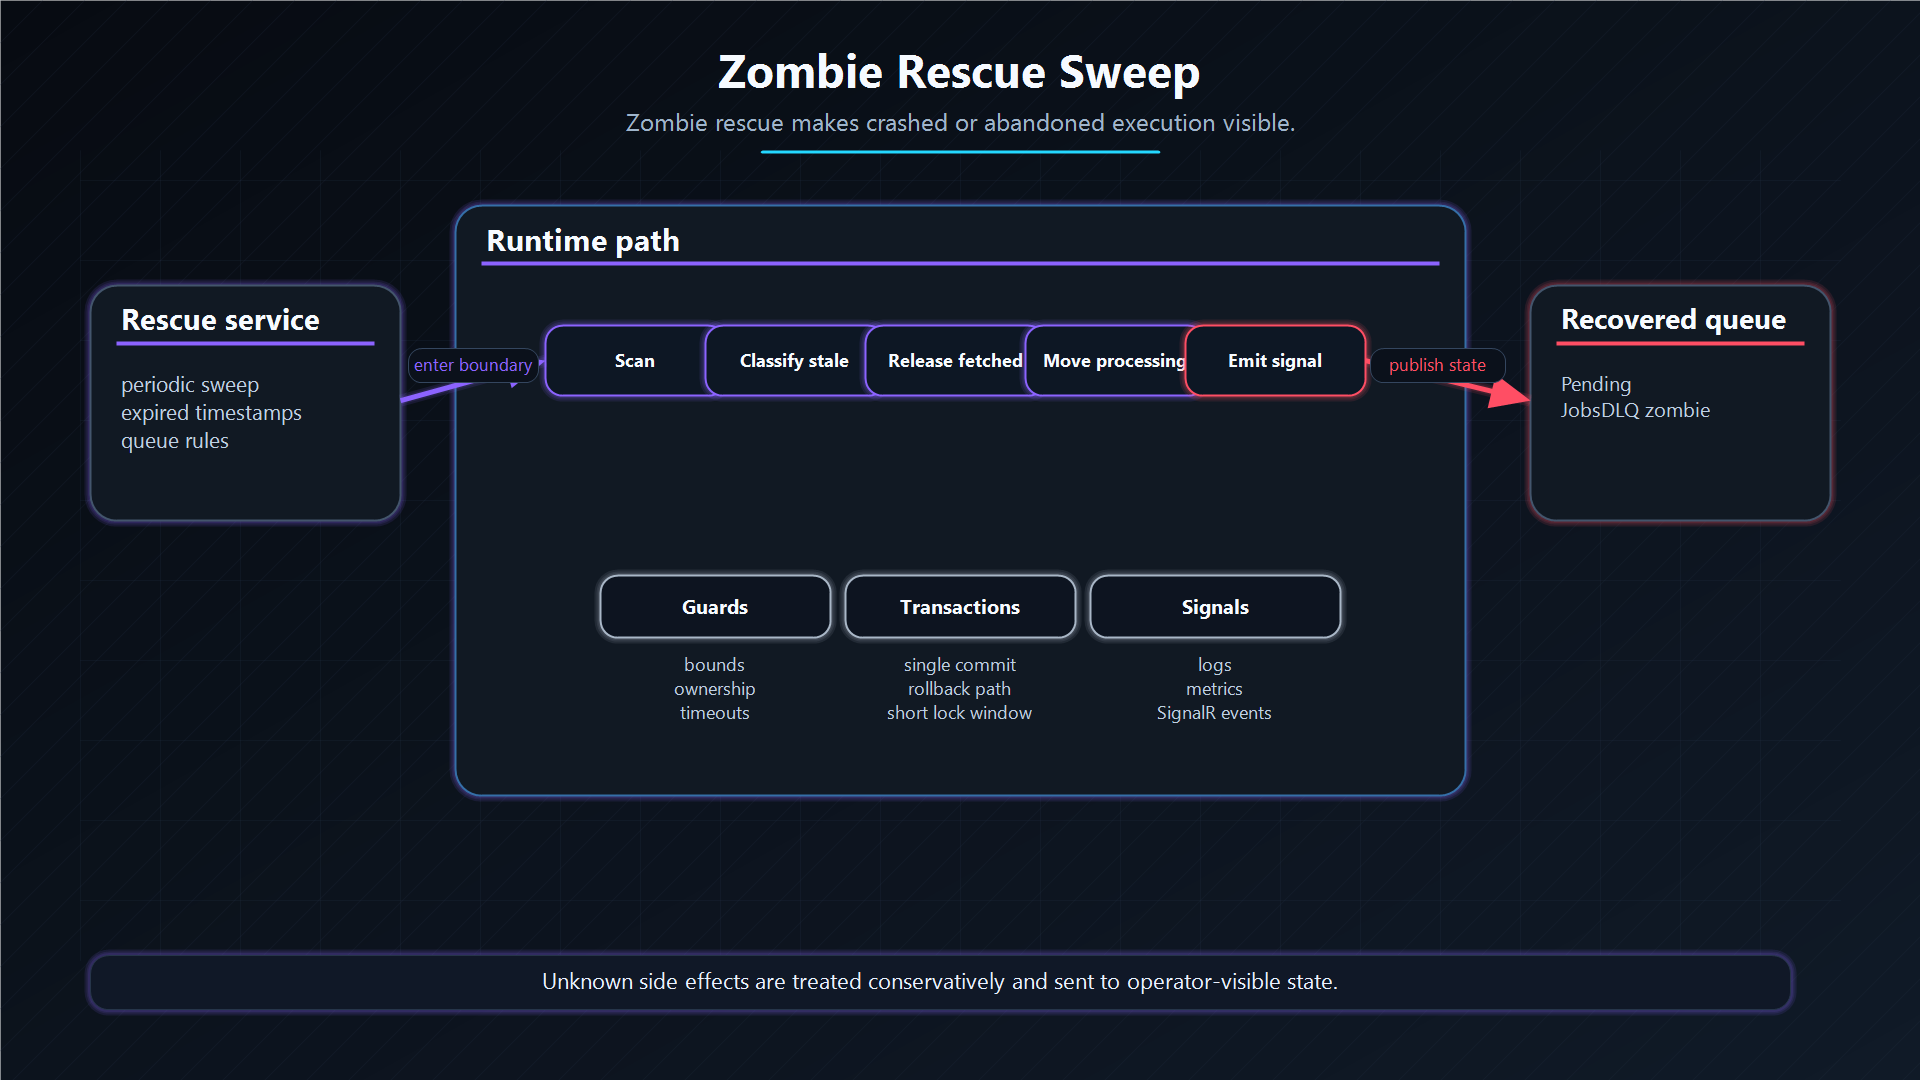
ZombieRescueService
BackgroundService, который запускается по ChokaQOptions.Recovery.ScanInterval и выполняет две recovery-фазы:
// From: ChokaQ.Core/Resilience/ZombieRescueService.cs

protected override async Task ExecuteAsync(CancellationToken ct)
{
    while (!ct.IsCancellationRequested)
    {
        try
        {
            // Phase 1: Recover abandoned jobs (Fetched but never processed)
            var recovered = await _storage.RecoverAbandonedAsync(
                options.FetchedJobTimeoutSeconds, ct);

            // Phase 2: Archive true zombies (Processing with expired heartbeat)
            var archived = await _storage.ArchiveZombiesAsync(
                options.ZombieTimeoutSeconds, ct);

            if (recovered > 0 || archived > 0)
            {
                _logger.LogWarning(
                    "ZombieRescue: Recovered {Recovered} abandoned, " +
                    "archived {Archived} zombies", recovered, archived);

                // Notify dashboard
                await _notifier.NotifyZombieRescueAsync(recovered, archived);
            }
        }
        catch (Exception ex)
        {
            _logger.LogError(ex, "ZombieRescue sweep failed");
        }

        await Task.Delay(options.Recovery.ScanInterval, ct);
    }
}
Фаза 1: Recover Abandoned Jobs
Проблема: воркер fetched batch заданий (Status = Fetched), но упал до перевода их в Processing. Эти задания заблокированы, но user code еще не стартовал.
Решение: сбросить их в Pending:
-- RecoverAbandonedAsync
UPDATE [chokaq].[JobsHot]
SET [Status] = 0,           -- Back to Pending
    [WorkerId] = NULL,       -- Clear worker assignment
    [LastUpdatedUtc] = SYSUTCDATETIME()
WHERE [Status] = 1           -- Fetched
  AND DATEDIFF(SECOND, [LastUpdatedUtc], SYSUTCDATETIME()) > @TimeoutSeconds
Эти задания возвращаются в очередь, потому что user code еще не запускался. Следующий fetch cycle может забрать их снова.
Recovery.FetchedJobTimeout намеренно отделен от Recovery.ProcessingZombieTimeout. Fetched jobs только зарезервированы в worker prefetch buffer; user code еще не выполнялся, поэтому recovery является safe retry. Processing jobs другие: они могли уже произвести side effects, поэтому их timeout основан на heartbeat и ведет в DLQ. Независимость двух timeout'ов не дает короткой processing heartbeat policy reclaim'ить здоровые задания, которые просто ждут execution slot.
Старые свойства FetchedJobTimeoutSeconds и ZombieTimeoutSeconds все еще существуют как compatibility aliases. Новым hosts лучше использовать вложенную секцию Recovery, потому что она чище мапится на appsettings.json.
Фаза 2: Archive True Zombies
Проблема: воркер начал processing (Status = Processing), но перестал обновлять heartbeat. Задание действительно застряло.
Решение: переместить в DLQ с FailureReason.Zombie:
-- ArchiveZombiesAsync — with per-queue timeout support
DELETE FROM [chokaq].[JobsHot]
OUTPUT
    DELETED.[Id], DELETED.[Queue], DELETED.[Type], DELETED.[Payload],
    DELETED.[Tags],
    2,                        -- FailureReason.Zombie
    'Zombie detected: heartbeat expired',
    DELETED.[AttemptCount], DELETED.[WorkerId],
    DELETED.[CreatedBy], NULL,
    DELETED.[CreatedAtUtc], SYSUTCDATETIME()
INTO [chokaq].[JobsDLQ](...)
FROM [chokaq].[JobsHot] h
LEFT JOIN [chokaq].[Queues] q ON h.[Queue] = q.[Name]
WHERE h.[Status] = 2          -- Only Processing jobs
  AND DATEDIFF(SECOND,
      ISNULL(h.[HeartbeatUtc], h.[LastUpdatedUtc]),
      SYSUTCDATETIME()
  ) > ISNULL(q.[ZombieTimeoutSeconds], @GlobalTimeout)
🎯 Per-Queue Timeouts
Обратите внимание на ISNULL(q.[ZombieTimeoutSeconds], @GlobalTimeout). Быстрый API call, например очередь sms, может иметь 30-second timeout, а тяжелая PDF generation в очереди reports - 30-minute timeout. ZombieRescueService учитывает эти индивидуальные thresholds.
Heartbeat contract
Во время processing JobProcessor запускает parallel heartbeat task:
Job processing:  ████████████████████████████████ (60 seconds)
Heartbeat:       ↑    ↑    ↑    ↑    ↑    ↑    ↑ (every ~10 seconds)
                 │    │    │    │    │    │    │
                 └────┴────┴────┴────┴────┴────┘
                   HeartbeatUtc updated each tick
Формула:
Execution.HeartbeatIntervalMin/Max= jittered heartbeat window, используемое воркером (~8-12s by default);Execution.HeartbeatFailureThreshold= число consecutive heartbeat write failures перед logging/counting degraded heartbeat state (~10 by default);Recovery.FetchedJobTimeout= сколько Fetched-but-not-started reservation может висеть перед возвратом в Pending;Recovery.ProcessingZombieTimeout= сколько Processing job может пропускать heartbeats перед признанием dead (~600s);Recovery.ProcessingZombieTimeoutдолжен быть значительно больше heartbeat interval.
Heartbeat write failures отправляются через chokaq.jobs.heartbeat_failures отдельно от handler failures. По умолчанию они не отменяют user code; включайте Execution.CancelOnHeartbeatFailure только если deployment хочет быстро fail'ить running work при heartbeat storage pressure.
Если HeartbeatUtc не обновлялся в течение Recovery.ProcessingZombieTimeout, задание либо:
- действительно застряло: infinite loop, deadlock;
- либо worker process умер.
В обоих случаях ZombieRescueService безопасно архивирует его.
Recovery vs Archive: решение
| Condition | Action | Why |
|---|---|---|
Status = Fetched + expired | Recover -> reset to Pending | Worker упал после fetch, но до processing. Job untouched, поэтому может вернуться в очередь. |
Status = Processing + expired heartbeat | Archive -> move to DLQ | Worker упал во время execution. Job мог быть частично обработан, поэтому перед retry нужен inspection. |
Processing zombies require inspection
Zombie в состоянии Processing мог частично выполнить side effects: отправить email, списать деньги или обновить database. ChokaQ перемещает такие задания в DLQ, чтобы оператор мог проверить состояние и решить, безопасен ли resurrection для этого handler'а и payload.
Dashboard integration
Когда ZombieRescueService обнаруживает zombies, он уведомляет The Deck через SignalR:
- Console event:
"⚠️ ZombieRescue: Recovered 2 abandoned, archived 1 zombie". - Stats update: счетчик DLQ увеличивается в real time.
- Job list: zombie появляется на DLQ panel с
FailureReason = Zombie. - Admin action: inspector показывает heartbeat details, admin может Resurrect или Purge.
Глубже: Heartbeat описывает liveness contract, а SQL Concurrency (UPDLOCK) подробно разбирает, как 50 воркеров fetch'ят без deadlocks.
Архитектурное решение
Zombie rescue разделяет два failure states, которые выглядят похоже, но имеют разные safety implications. Fetched jobs были зарезервированы воркером, но user code не запускался, поэтому их можно безопасно вернуть в Pending. Processing jobs могли уже произвести side effects, поэтому ChokaQ перемещает их в DLQ вместо automatic retry.
Альтернатива - automatic retry для каждого expired lease. Это максимизирует throughput recovery, но может продублировать side effects после process crash. ChokaQ выбирает operator-visible safety, потому что background jobs часто взаимодействуют с email, payments, files и external APIs.
Результат - conservative recovery model: untouched reservations reclaim'ятся автоматически, а uncertain executions требуют inspection, уверенности в idempotency и явного resurrect decision.
Дополнительные вопросы
Почему Fetched и Processing jobs обрабатываются по-разному?
Fetched означает, что строка находится в local prefetch buffer, и user code еще не выполнялся. Processing означает, что handler стартовал и мог выполнить side effects.
Почему heartbeat expiration не retry'ит задание сразу?
Потому что heartbeat loss говорит только о том, что worker перестал reporting, а не о том, завершилась ли business operation. Retry без inspection может продублировать external effects.
Как operators должны решать, resurrect'ить ли zombie?
Нужно проверить idempotency guarantees handler'а, downstream state и payload. Если operation idempotent или внешне подтверждено, что она не завершилась, resurrection разумен; иначе оставьте задание в DLQ или purge по policy.