
Backpressure Policy
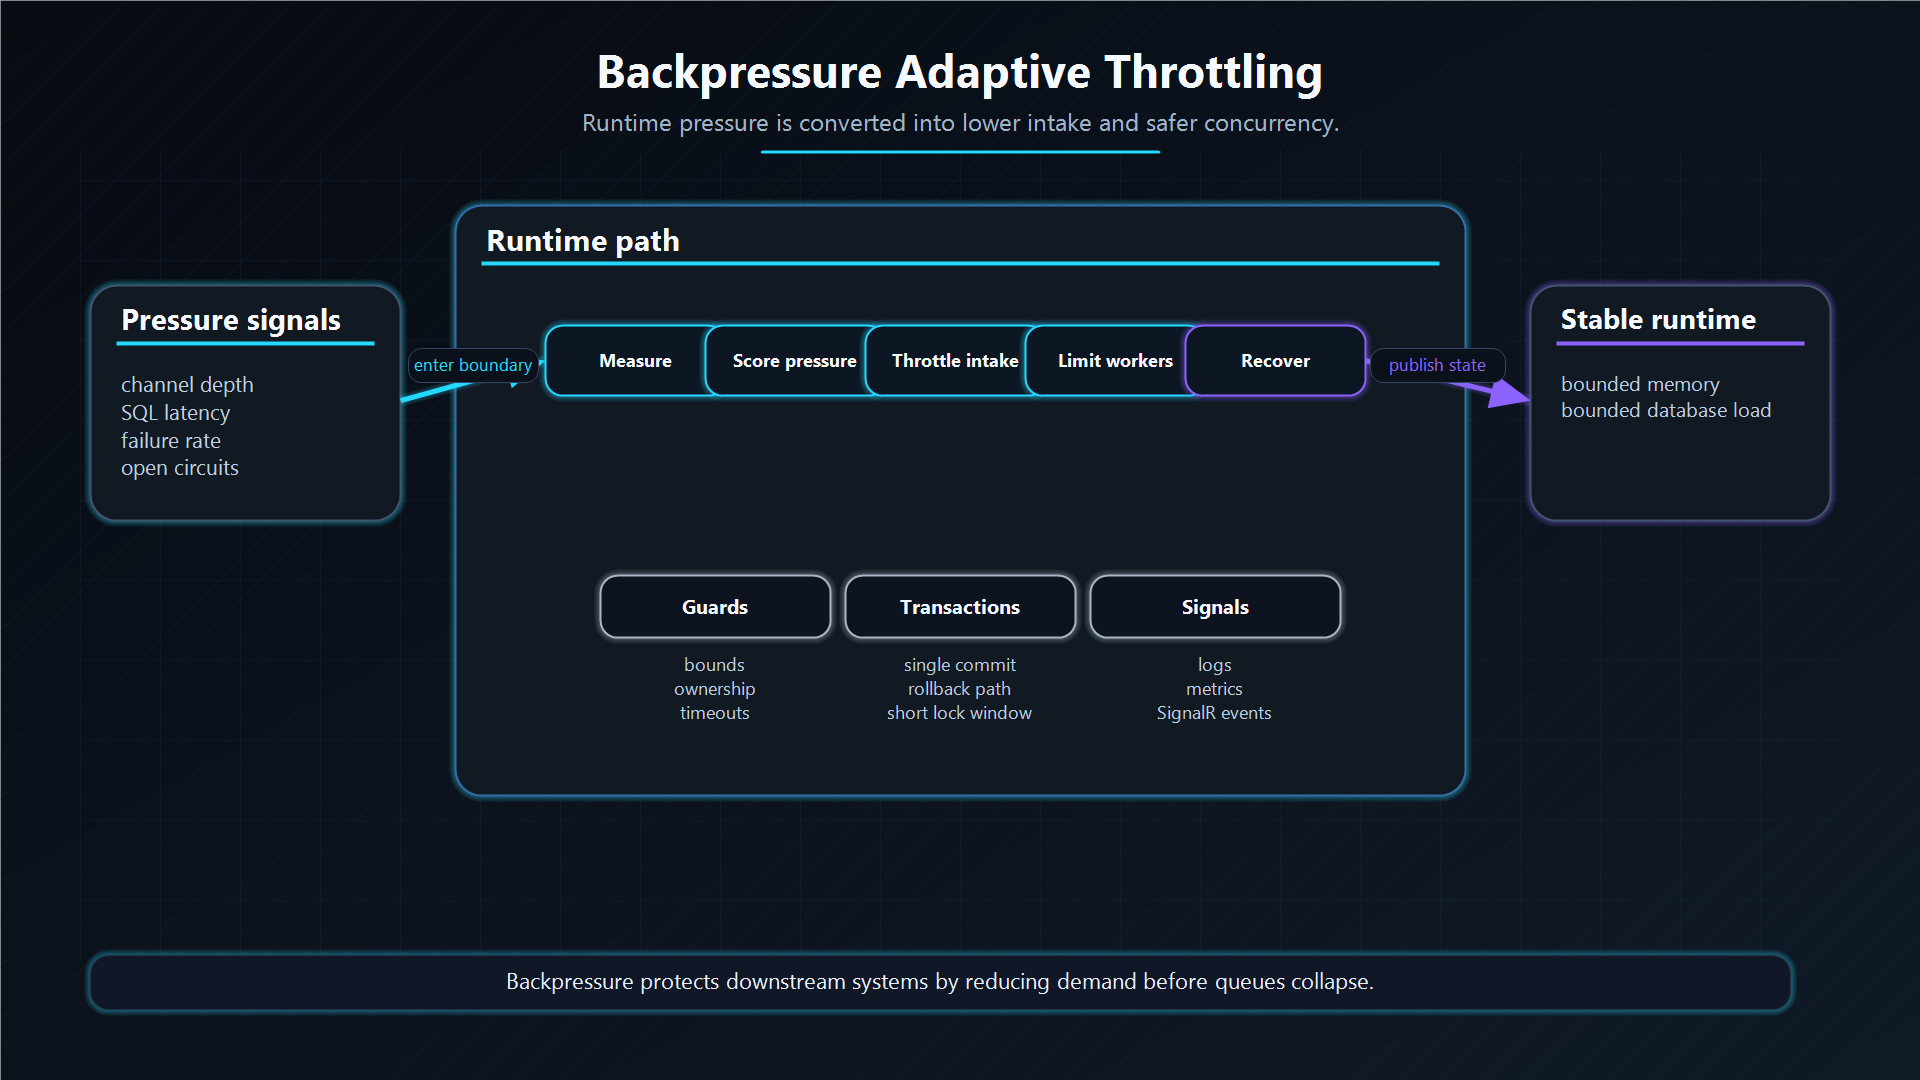
Backpressure - это часть queue system, которая отвечает на простой production-вопрос: что происходит, когда producers создают работу быстрее, чем workers успевают ее завершать?
У ChokaQ разные ответы для in-memory mode и SQL Server mode, потому что producer/consumer boundary в них устроена по-разному. Эта страница фиксирует эти ответы, чтобы operators настраивали систему осознанно, а не выясняли pressure behavior во время incident.
Policy summary
| Mode | Producer boundary | Backlog location | Pressure behavior | Production fit |
|---|---|---|---|---|
| In-memory | Bounded Channel<IChokaQJob> inside the process | Process memory | Producers ждут, когда channel full; storage evicts old Archive/DLQ rows before Hot rows | Demos, tests, volatile streams |
| SQL Server | Durable insert into JobsHot | SQL Server | Producers возвращаются после commit; workers self-throttle через bounded prefetch и polling | Production, multi-instance, restart-safe work |
Ключевое различие: in-memory mode возвращает pressure caller'у в том же process, а SQL mode durable-хранит backlog и дает operators сигналы через queue lag, health checks и worker capacity.
In-Memory Mode
In-memory mode имеет два pressure controls:
InMemory.MaxCapacityуправляет тем, сколько job history хранит in-process Three Pillars store.InMemoryQueueиспользует boundedChannel<IChokaQJob>, чтобы producer calls не создавали unbounded notification buffer.
Default InMemory.MaxCapacity - 100000.
{
  "ChokaQ": {
    "InMemory": {
      "MaxCapacity": 100000
    }
  }
}
Когда storage достигает этого soft cap, он сначала evict'ит старые Archive rows, затем старые DLQ rows. Hot rows сохраняются, потому что это accepted work, которую worker еще должен увидеть. Это намеренно не production durability policy: если process умирает, in-memory data исчезает.
Producer calls пишут в bounded channel после acceptance Hot row. Когда channel full, WriteAsync ждет, пока workers освободят место. Это ожидание и есть backpressure signal: caller видит более медленный enqueue latency вместо того, чтобы process бесконтрольно рос по memory.
Используйте in-memory mode, когда потеря process-local work допустима или когда host уже владеет higher-level replay mechanism.
SQL Server Mode
SQL Server mode использует database как durable backlog:
SqlChokaQQueue.EnqueueAsyncсериализует job и вставляет Pending row вJobsHot.- Producer возвращается после commit SQL command.
SqlJobWorkerpoll'итJobsHot, atomically claim'ит rows и кладет claimed rows в bounded local prefetch buffer.- Когда local buffer full, fetcher перестает claim'ить новые rows, пока processors его не drain'ят.
Это означает, что producer backpressure в основном становится database pressure: connection pool limits, command timeouts, SQL Server IO/log throughput и application-level rate limits. ChokaQ не drop'ает новые jobs только потому, что workers отстают. Backlog остается в JobsHot, пока workers не догонят, operators не pause/requeue work или retention/administrative policies не сработают на history.
Prefetch buffer SQL worker'а намеренно не является второй durable queue. Это небольшой in-process smoothing buffer. Если worker остановится до выполнения prefetched rows, shutdown и abandoned-fetch recovery release'ят эти rows обратно в Pending, чтобы другой worker мог их claim'ить.
На что смотреть
Backpressure нужно наблюдать через age, а не только через count.
| Signal | Meaning | Action |
|---|---|---|
| Queue lag | Oldest Pending jobs ждут слишком долго | Добавить workers, поднять queue MaxWorkers, split queues или снизить producer rate |
| Worker health | Worker loop остановился или heartbeat stale | Restart host, inspect logs, проверить dependency failures |
| SQL command timeout | Database не успевает за storage/admin reads/writes | Tune indexes, снизить dashboard/admin load, scale SQL или замедлить producers |
| DLQ rate | Workers обрабатывают, но jobs fail'ятся | Исправить downstream dependency, payload, timeout или code issue |
Queue depth может быть полезной, но age дает более сильный operational signal. Queue с множеством tiny jobs может быть здоровой; queue с несколькими очень старыми jobs может быть saturated. Поэтому ChokaQ показывает queue lag в The Deck и health checks.
Tuning levers
| Lever | Applies to | Effect |
|---|---|---|
Queue MaxWorkers | SQL and in-memory fetch paths | Ограничивает concurrent active jobs per queue |
| Worker count | Worker manager / The Deck | Управляет process-local execution parallelism |
SqlServer.PollingInterval | SQL worker | Управляет idle polling frequency, когда queues active |
SqlServer.NoQueuesSleepInterval | SQL worker | Управляет sleep time, когда все queues paused или inactive |
SqlServer.CommandTimeoutSeconds | SQL storage | Ограничивает время ChokaQ SQL commands |
InMemory.MaxCapacity | In-memory storage | Ограничивает retained in-process history перед eviction старых Archive/DLQ |
Worker.PausedQueuePollingDelay | In-memory worker | Не дает paused queues создать tight requeue loop |
Recommended operating model
Для production workloads используйте SQL Server mode и считайте JobsHot durable pressure boundary. Alert'ьте queue lag и worker health, а не только process CPU или memory. Если lag растет при низком числе failures, scale workers или снижайте producer rate. Если lag растет вместе с SQL timeouts, bottleneck находится в database. Если растет DLQ rate, capacity, скорее всего, не root cause; сначала смотрите failure taxonomy.
Для in-memory workloads держите InMemory.MaxCapacity явным и достаточно малым для host process. Помните: in-memory mode защищает process от unbounded local buffers, но не защищает accepted work от process loss.
Архитектурное решение
ChokaQ намеренно разделяет durable backlog pressure и local execution pressure. SQL Server mode принимает work в JobsHot и использует database как source of truth для backlog, а workers используют bounded prefetch и queue limits, чтобы один process не стал unbounded second queue.
Альтернативой был бы producer-side rejection, когда workers отстают. Это может быть полезно для request throttling, но ChokaQ выбирает другой default для durable background work: после acceptance job caller может ожидать, что она переживет restarts и temporary worker shortages. Поэтому ChokaQ трактует enqueue success как durable acceptance, а pressure signals для operators - это queue lag, SQL latency и worker health.
Trade-off явный: система защищает accepted jobs, но не защищает database магически от unlimited producer. Production systems все еще нуждаются в API rate limits, capacity planning, alerting и queue-specific worker limits.
Дополнительные вопросы
Почему не использовать unbounded channel между fetch и processing?
Потому что unbounded channel скрывает pressure, пока memory не станет failure mode. Bounded channel заставляет fetch loop перестать claim'ить новые rows, когда local processors не успевают.
Почему SQL mode не блокирует producers, когда workers saturated?
Потому что SQL mode использует JobsHot как durable backlog. После commit row job accepted и restart-safe. Saturation обрабатывается операционно через lag, scaling, pausing, bulkheads и producer rate limits.
Когда команде не стоит использовать эту модель?
Если workload требует synchronous admission control с жестким immediate rejection под pressure, поставьте rate limiter или quota check перед enqueue. Queue ChokaQ - durable execution boundary, а не единственный traffic-control mechanism приложения.
Дальше: детали In-Memory Engine или fetch path в SQL Concurrency.