
Runtime Configuration
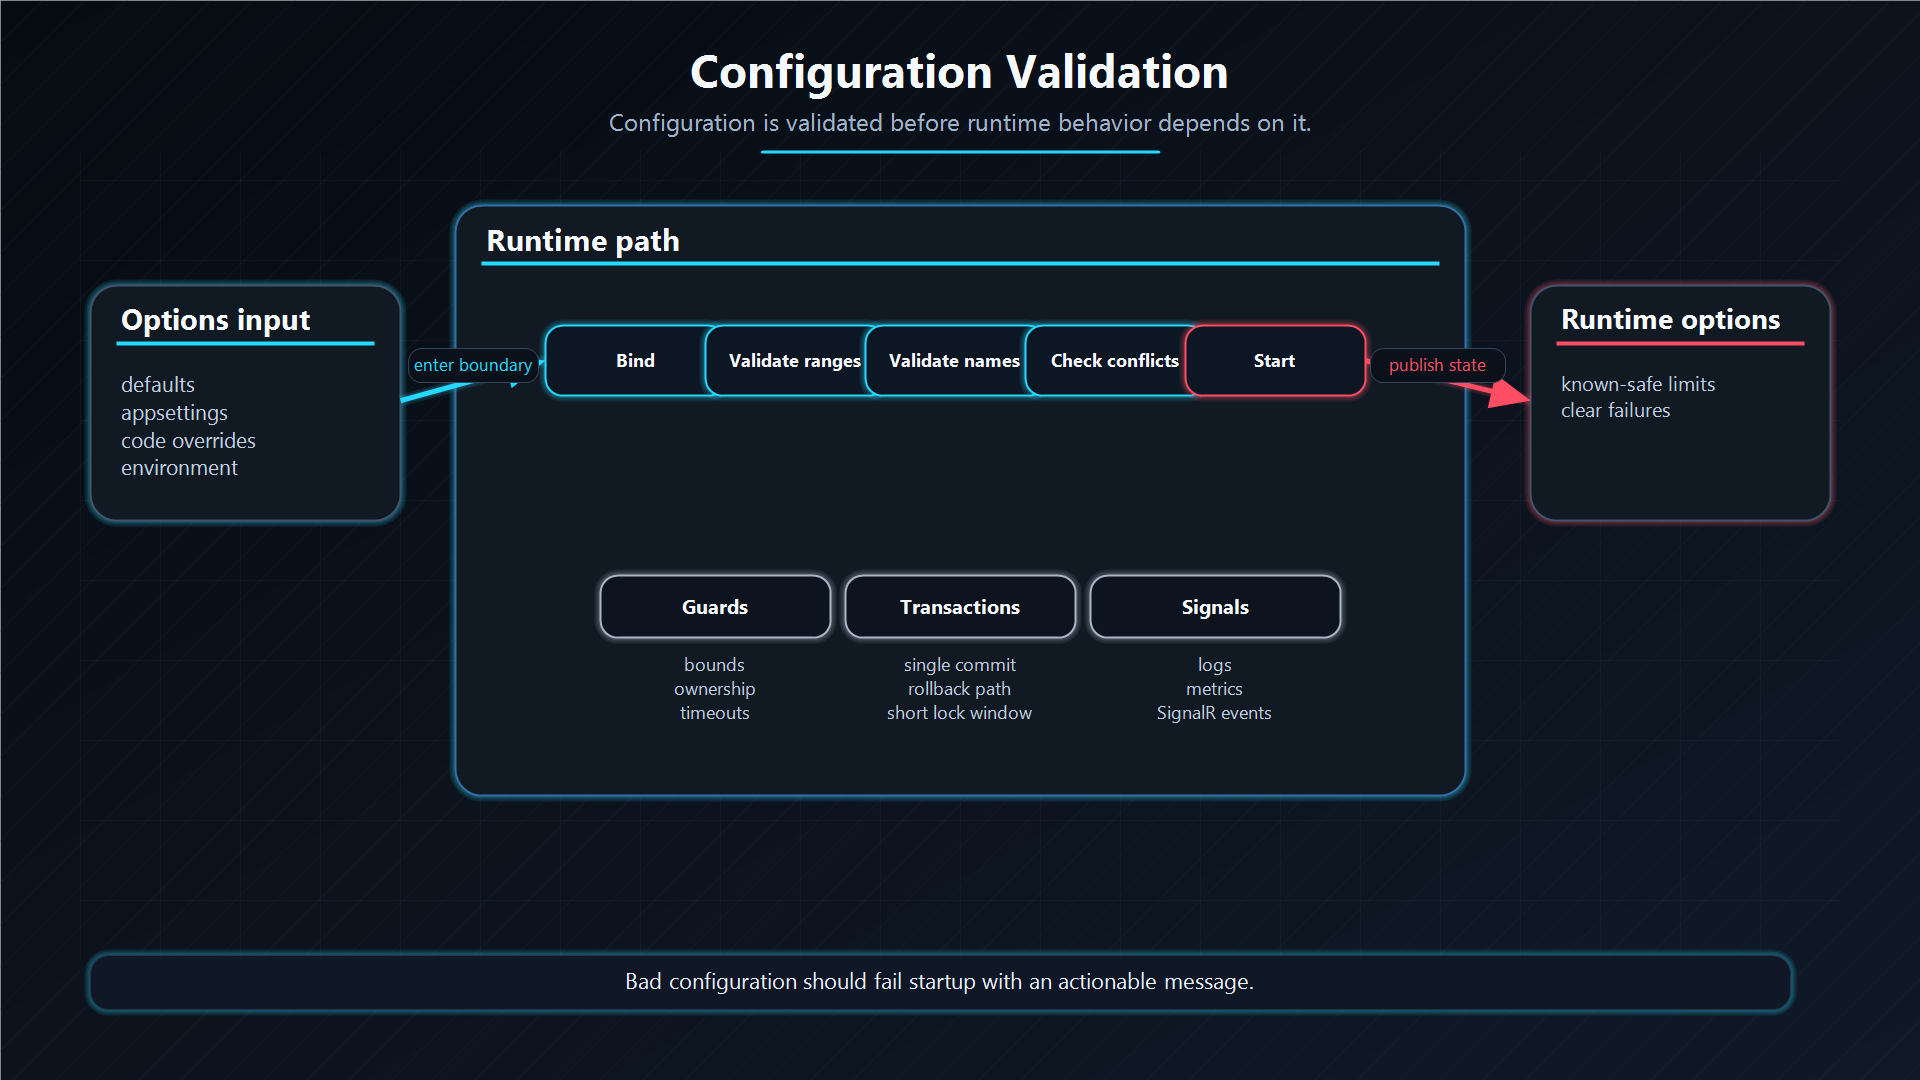
Configuration - это место, где host application описывает операционную политику.
Код говорит ChokaQ, какие jobs существуют. Configuration говорит ChokaQ, как runtime должен вести себя в конкретной среде: сколько может выполняться handler, как retries делают backoff, когда health становится degraded, какую SQL schema использовать и какая metric cardinality допустима.
ChokaQ рассчитан на package consumption, поэтому production hosts должны иметь возможность держать operational policy в appsettings.json, environment variables, Key Vault-backed configuration или любом другом IConfiguration provider.
Code defaults намеренно консервативны. Они позволяют запустить локальный demo без конфигурации, но каждый важный timeout и retry policy может быть явно задан host application.
Configuration не меняет delivery contract ChokaQ. ChokaQ дает at-least-once execution; он не дает exactly-once external side effects. Перед настройкой production queues, retries, timeouts или shutdown behavior прочитайте Delivery Guarantees.
SQL storage retry settings описаны в SQL Transient Retry Policy.
Payload и metadata limits описаны в Serialization And Envelope Limits.
Queue runtime controls описаны в Queue Controls.
Как думать о настройках
Большинство настроек отвечают на один из пяти вопросов:
| Вопрос | Область конфигурации | Пример |
|---|---|---|
| Как долго может выполняться пользовательский код? | Execution | DefaultTimeout |
| Что происходит после transient failure? | Retry | BaseDelay, MaxAttempts, JitterMaxDelay |
| Как workers восстанавливают abandoned work? | Recovery | FetchedJobTimeout, ProcessingZombieTimeout |
| Когда monitoring должен жаловаться? | Health | QueueLagUnhealthyThreshold |
| Как ведет себя SQL storage? | SqlServer | SchemaName, CommandTimeoutSeconds, CleanupBatchSize |
Для локального demo начните с defaults. Для реального сервиса сделайте важные значения явными и храните их вместе с конфигурацией host application.
Рекомендуемый Program.cs
var builder = WebApplication.CreateBuilder(args);

builder.Services.AddChokaQ(
    builder.Configuration.GetSection("ChokaQ"),
    options =>
    {
        // Profiles and middleware are compile-time registrations.
        // Runtime policy comes from appsettings unless code intentionally overrides it here.
        options.AddProfile<MailingProfile>();
        options.AddMiddleware<CorrelationMiddleware>();
    });

builder.Services.UseSqlServer(
    builder.Configuration.GetSection("ChokaQ:SqlServer"));

builder.Services.AddHealthChecks()
    .AddChokaQSqlServerHealthChecks(builder.Configuration.GetSection("ChokaQ:Health"));
Порядок binding:
- Code defaults ChokaQ.
- Значения из
IConfiguration. - Optional code callback overrides.
- Per-queue runtime overrides там, где они поддерживаются.
Такой порядок позволяет platform teams держать environment policy в configuration, а application code по-прежнему владеет type-safe registrations: profiles, handlers и middleware.
appsettings.json
{
  "ChokaQ": {
    "Execution": {
      "DefaultTimeout": "00:15:00",
      "HeartbeatIntervalMin": "00:00:08",
      "HeartbeatIntervalMax": "00:00:12",
      "HeartbeatFailureThreshold": 10,
      "CancelOnHeartbeatFailure": false,
      "PendingCancellationRetention": "00:00:30"
    },
    "Retry": {
      "MaxAttempts": 3,
      "BaseDelay": "00:00:03",
      "MaxDelay": "01:00:00",
      "BackoffMultiplier": 2.0,
      "JitterMaxDelay": "00:00:01",
      "CircuitBreakerDelay": "00:00:05",
      "MaxJobAge": "1.00:00:00"
    },
    "Recovery": {
      "FetchedJobTimeout": "00:10:00",
      "ProcessingZombieTimeout": "00:10:00",
      "ScanInterval": "00:01:00"
    },
    "Worker": {
      "PausedQueuePollingDelay": "00:00:01",
      "ShutdownGracePeriod": "00:00:30"
    },
    "InMemory": {
      "MaxCapacity": 100000
    },
    "Health": {
      "WorkerHeartbeatTimeout": "00:00:30",
      "QueueLagDegradedThreshold": "00:00:05",
      "QueueLagUnhealthyThreshold": "00:00:10"
    },
    "Metrics": {
      "MaxQueueTagValues": 100,
      "MaxJobTypeTagValues": 500,
      "MaxErrorTagValues": 100,
      "MaxFailureReasonTagValues": 50,
      "MaxTagValueLength": 128,
      "UnknownTagValue": "unknown",
      "OverflowTagValue": "other"
    },
    "Serialization": {
      "MaxPayloadBytes": 1000000
    },
    "Idempotency": {
      "InProgressTtl": "00:30:00",
      "DefaultResultTtl": null,
      "MinResultTtl": null,
      "MaxResultTtl": null
    },
    "TypeResolution": {
      "RequireRegisteredJobTypes": true
    },
    "Queues": {
      "reports": {
        "ExecutionTimeout": "01:00:00"
      }
    },
    "SqlServer": {
      "ConnectionString": "Server=localhost;Database=ChokaQ;Trusted_Connection=True;TrustServerCertificate=True;",
      "SchemaName": "chokaq",
      "AutoCreateSqlTable": false,
      "PollingInterval": "00:00:01",
      "NoQueuesSleepInterval": "00:00:05",
      "CommandTimeoutSeconds": 30,
      "CleanupBatchSize": 1000,
      "WorkerShutdownGracePeriod": "00:00:30",
      "PrefetchedJobReleaseTimeout": "00:00:05",
      "MaxTransientRetries": 3,
      "TransientRetryBaseDelayMs": 200
    }
  }
}
Execution
Execution.DefaultTimeout - жесткий wall-clock limit для job handler. Если пользовательский код не завершился до timeout, ChokaQ отменяет handler token и проводит job через timeout path.
Зачем это нужно: stuck handler может удерживать worker lease бесконечно. Это скрывает queue saturation, мешает запуску других jobs и заставляет операторов исправлять систему вручную. У background processor должна быть явная execution boundary.
Timeout - это не тот же операционный intent, что admin cancellation. Timeout означает, что execution boundary превышена. Admin cancellation означает, что оператор или API попросил ChokaQ остановить или удалить работу. В runbooks, dashboards и application logic эти outcomes нужно разделять.
Queues:{queueName}:ExecutionTimeout переопределяет global timeout для одной queue. Используйте это для реальных различий workload. Например, queue reports может требовать один час, а default queue должна fail fast через пятнадцать минут.
Execution.HeartbeatFailureThreshold управляет тем, когда повторяющиеся heartbeat write failures становятся degraded execution signal. Default - 10 последовательных failures. ChokaQ записывает chokaq.jobs.heartbeat_failures и логирует degraded heartbeat state; по умолчанию он не отменяет пользовательский код, потому что heartbeat failure часто указывает на SQL/network pressure, а не на плохой handler.
Выставляйте Execution.CancelOnHeartbeatFailure = true только если deployment предпочитает fail-fast cancellation вместо того, чтобы zombie recovery принял финальное решение по abandoned job.
Execution.PendingCancellationRetention закрывает маленькую race condition, в которой admin cancellation доходит до processor прямо перед регистрацией execution token. Expired pending cancels игнорируются, чтобы более поздняя resurrection с тем же job ID не унаследовала stale cancellation.
Retry
Retry.MaxAttempts - максимальное общее число executions, включая первую попытку. Старое свойство MaxRetries еще существует для compatibility, но в новой конфигурации нужно использовать Retry.MaxAttempts.
Retry.BaseDelay, Retry.BackoffMultiplier и Retry.MaxDelay определяют exponential backoff. С defaults retry delays начинаются с трех секунд, удваиваются после каждой неуспешной попытки и никогда не превышают один час.
Retry.JitterMaxDelay добавляет случайность в retry scheduling. Jitter мешает тысячам jobs повториться в одну и ту же миллисекунду после downstream outage. Jitter обрезается Retry.MaxDelay, поэтому max delay остается настоящим операционным cap.
Retry.CircuitBreakerDelay используется, когда circuit breaker блокирует job type. Job переносится на будущий запуск вместо немедленного execution, что снижает pressure на dependency, которая уже unhealthy.
Retry.MaxJobAge - wall-clock lifetime budget для retry job. Default - один день. Если следующий retry должен быть scheduled после CreatedAtUtc + MaxJobAge, ChokaQ переносит job в DLQ с FailureReason.RetryLifetimeExpired, а не держит старую работу живой вечно. Ставьте null только если приложение владеет другой lifetime boundary.
Recovery
Recovery.FetchedJobTimeout применяется к jobs, которые worker забрал, но еще не начал выполнять пользовательский код. Восстанавливать такие jobs безопасно, потому что handler side effects еще не произошли.
Recovery.ProcessingZombieTimeout применяется к jobs, которые начали пользовательский код, но перестали отправлять heartbeats. Такие jobs переносятся в DLQ как zombies, потому что они уже могли произвести side effects и требуют inspection.
Recovery.ScanInterval управляет тем, как часто ZombieRescueService ищет abandoned и zombie jobs. Более короткий interval снижает time-to-recovery. Более длинный interval снижает database load.
In-Memory
InMemory.MaxCapacity - soft cap для jobs, удерживаемых in-process Three Pillars store. Default - 100000. Когда cap достигнут, ChokaQ сначала evicts старые Archive rows, затем старые DLQ rows. Hot rows сохраняются, потому что они представляют accepted work, которую in-memory worker еще должен обработать.
Зачем это нужно: in-memory mode полезен для demos, tests, local development и volatile streams, но process memory - не бесконечная очередь. Cap не дает historical rows расти без ограничений и делает tradeoff явным: SQL Server mode
- production choice, когда важны backlog durability и restart survival.
In-memory worker управляется channel. Bounded Channel<IChokaQJob> является volatile execution notification source, а in-process Hot row - control/audit row, который позволяет worker отвергать stale channel items. Worker выполняет job только если Hot row все еще Pending, а persisted type key и payload совпадают с channel item. Orphaned Hot rows могут остаться после process crash между enqueue/resurrection и channel drain; они не восстанавливаются через process restart. Для durable backlog и restart-safe admin restart используйте SQL Server mode.
Worker.ShutdownGracePeriod ограничивает, как долго in-memory worker shutdown ждет, пока worker loops увидят cancellation.
Полная policy описана в Backpressure Policy.
SQL Server
SqlServer.PollingInterval управляет тем, как часто SQL worker делает polling, когда active queues существуют, но доступных jobs сейчас нет.
SqlServer.NoQueuesSleepInterval управляет sleep duration, когда все queues paused или inactive.
SqlServer.CommandTimeoutSeconds - максимальное время для каждой SQL command, которую выполняет ChokaQ. Это относится к worker fetches, state transitions, dashboard reads, recovery scans и admin commands. Это не управляет выполнением пользовательского handler; за это отвечает Execution.DefaultTimeout.
SqlServer.CleanupBatchSize - максимальное число Archive или DLQ rows, которые ChokaQ удаляет в одной cleanup transaction. Default - 1000. Уменьшайте значение, если SQL Server общий с latency-sensitive workloads или transaction-log pressure важнее скорости cleanup. Увеличивайте, если retention cleanup должен быстро догнать backlog, а у базы достаточно log и IO headroom.
Зачем это нужно: retention cleanup - операционное обслуживание, а не пользовательская работа. Один огромный DELETE может удерживать locks, раздувать transaction log и заставлять workers или dashboard queries ждать. Batching cleanup дает administrators простой pressure valve и сохраняет purge APIs удобными.
SqlServer.MaxTransientRetries и SqlServer.TransientRetryBaseDelayMs настраивают retries вокруг transient SQL failures, например deadlocks или кратких network blips. Эти retries защищают storage operations, а не user job handlers.
SqlServer.WorkerShutdownGracePeriod ограничивает, как долго SQL worker ждет active processing tasks во время shutdown. Handler, который игнорирует cancellation, может пережить этот budget; если host затем убьет процесс, Processing row позже обработает zombie recovery.
SqlServer.PrefetchedJobReleaseTimeout ограничивает cleanup call, который возвращает prefetched, но unstarted Fetched jobs в Pending во время pause или shutdown.
Когда AutoCreateSqlTable включен, ChokaQ также создает [schema].[SchemaMigrations]. Эта таблица хранит примененную версию SQL schema ChokaQ. Version 1 представляет initial Three Pillars schema, version 2 фиксирует hot-path index hardening, version 3 добавляет rolling MetricBuckets для materialized throughput и failure-rate windows. Future SQL migrations должны добавлять одну row после успешного применения, чтобы operators имели database-side audit trail при upgrades.
Metrics
ChokaQ emits OpenTelemetry instruments через System.Diagnostics.Metrics с meter name ChokaQ. Библиотека не устанавливает exporters; host application сама решает, отправлять metrics в Prometheus, OTLP, Application Insights или другой backend.
| Instrument | Type | Unit | Tags | Meaning |
|---|---|---|---|---|
chokaq.jobs.enqueued | Counter | none | queue, type | Jobs, принятые storage. |
chokaq.jobs.completed | Counter | none | queue, type | Jobs, archived as successful. |
chokaq.jobs.failed | Counter | none | queue, type, error | Handler executions, которые threw. |
chokaq.jobs.processing_duration | Histogram | ms | queue, type | Wall-clock duration handler. |
chokaq.jobs.queue_lag | Histogram | ms | queue, type | Время ожидания job перед execution. |
chokaq.jobs.dlq | Counter | none | queue, type, reason | Jobs, перенесенные в DLQ. |
chokaq.jobs.retried | Counter | none | queue, type, attempt | Jobs, scheduled на еще одну попытку. |
chokaq.workers.active | UpDownCounter | none | queue | Active worker delta по queue. |
chokaq.jobs.heartbeat_failures | Counter | none | queue, type | Failed per-job heartbeat writes. |
chokaq.jobs.state_transition_conflicts | Counter | none | queue, type, transition | Worker-owned state transitions, которые не затронули rows. |
chokaq.idempotency.claims | Counter | none | outcome | Idempotency claim-store outcomes: claimed, duplicate, released или completion conflict. |
chokaq.circuits.events | Counter | none | type, state, event | Circuit breaker open, close, reject, half-open probe, release и timeout events. |
Metrics.MaxQueueTagValues, Metrics.MaxJobTypeTagValues, Metrics.MaxErrorTagValues и Metrics.MaxFailureReasonTagValues ограничивают число distinct tag values, которое один process emits для каждой tag family. Когда budget исчерпан, новые значения reported as Metrics.OverflowTagValue вместо создания новых time series.
Metrics.UnknownTagValue заменяет blank tag values. Metrics.MaxTagValueLength обрезает длинные values до cardinality tracking. Defaults сохраняют полезные operator dimensions и одновременно предотвращают случайную unbounded cardinality.
Зачем это нужно: labels - опасная часть metrics. Stable counter name дешев; tag с tenant IDs, generated queue names, exception messages или user data может создать тысячи time series и сделать monitoring backend медленным или дорогим. ChokaQ сохраняет high-value dimensions, но ставит жесткий ceiling на ущерб, который может создать один process.
Operational runbooks:
Serialization
Serialization.MaxPayloadBytes - максимальный UTF-8 byte size serialized job payload, который enqueue принимает. Oversized payloads падают до storage mutation, поэтому producers получают понятное boundary violation вместо provider-specific SQL или memory failure.
Default Bus-mode serializer использует общие System.Text.Json options через serializer contract ChokaQ. Его default casing соответствует обычной System.Text.Json serialization, а не ASP.NET Core Web defaults, поэтому существующие PascalCase payloads остаются compatible. Hosts, которым нужно другое JSON behavior, могут заменить IChokaQJobSerializer в DI до того, как ChokaQ создает jobs, но изменение serializer behavior влияет на old rows, уже сохраненные в SQL, Archive или DLQ.
Относитесь к persisted payloads как к message contracts. Additive DTO changes обычно безопаснее rename или removals; breaking schema changes должны использовать новый profile type key, например email.send.v2.
Idempotency
Idempotency.InProgressTtl управляет тем, как долго optional idempotency middleware хранит active execution claim до того, как другой worker сможет claim тот же idempotency key. Ставьте его длиннее normal execution time для protected operation.
Idempotency.DefaultResultTtl используется, когда IIdempotentJob возвращает null из ResultTtl. MinResultTtl и MaxResultTtl могут enforce business retention bounds, чтобы один job случайно не хранил completion markers слишком мало или слишком долго.
Built-in in-memory idempotency store является claim-based: первое execution записывает InProgress claim, concurrent duplicates видят AlreadyInProgress и пропускают handler execution, а successful completion записывает completion marker. Handler failure releases claim, чтобы более поздний retry мог выполниться. Expired in-memory claim и completion entries удаляются opportunistically в bounded cleanup passes по мере использования store, но этот store все равно process-local development infrastructure, а не durable production state.
Для production multi-instance deployments используйте shared store. Redis strategy должна использовать atomic SET ... NX ... EX или Lua scripts для begin/complete/release state transitions. SQL strategy должна использовать unique key плюс atomic insert/update transactions. Stores, которые реализуют только старый интерфейс IIdempotencyStore, адаптируются для source compatibility, но не дают таких же atomic in-progress claim semantics.
Type Resolution
TypeResolution.RequireRegisteredJobTypes управляет тем, должны ли Bus-mode enqueue и dispatch требовать, чтобы каждый job DTO был зарегистрирован через ChokaQJobProfile.
Для production выставляйте true. Registered profile keys, например email.send.v1, являются stable persisted message-contract names и переживают CLR renames или namespace refactors.
Когда значение false, unregistered Bus jobs могут использовать assembly-qualified CLR fallback identity для compatibility. ChokaQ не сохраняет и не resolves unregistered jobs по CLR short name, потому что два разных namespaces могут содержать classes с одинаковым short name. Когда значение true, persisted assembly-qualified fallback identities также reject на dispatch; зарегистрируйте type key или мигрируйте old row.
Structured Log Events
ChokaQ emits lifecycle logs со стабильными EventId. Message template - для людей; event ID - для машин. Используйте EventId.Id или EventId.Name в SIEM queries, alert rules и runbooks вместо fragile text snippets.
| Range | Area | Examples |
|---|---|---|
1000-1099 | Worker service and loop lifecycle. | WorkerStarted, WorkerStopped, WorkerLoopCrashed |
2000-2099 | Individual job execution lifecycle. | JobSucceededArchived, JobTimedOutOrCancelled |
2100-2199 | Persisted state transitions and UI notification plumbing. | StateTransitionNotApplied, NotificationFailed |
3000-3099 | Enqueue producer boundary. | EnqueueDuplicateSkipped, EnqueueNotificationFailed |
4000-4099 | Recovery and zombie rescue. | AbandonedJobsRecovered, ZombieJobsArchived |
5000-5099 | SQL provisioning and storage boundary. | SqlInitializationStarted, SqlInitializationFailed |
6000-6099 | Operator/admin command boundary. | AdminCommandRejected, AdminCommandCompleted |
Зачем это нужно: background processors fail across multiple layers. Job может быть rejected by circuit breaker, lose worker ownership, retry, move to DLQ или быть changed by operator. Stable event IDs позволяют on-call engineer восстановить этот path, даже если wording log messages изменится в будущей версии.
Health Checks
ChokaQ интегрируется со стандартным ASP.NET Core health-check pipeline. Это правильная граница для host applications и будущих package consumers: host решает route, authentication, Kubernetes probes и monitoring integration, а ChokaQ добавляет domain-specific checks.
Для SQL Server mode:
builder.Services.AddHealthChecks()
    .AddChokaQSqlServerHealthChecks(builder.Configuration.GetSection("ChokaQ:Health"));

app.MapHealthChecks("/health");
Для in-memory или pipe-only mode:
builder.Services.AddHealthChecks()
    .AddChokaQHealthChecks(builder.Configuration.GetSection("ChokaQ:Health"));

app.MapHealthChecks("/health");
Registered check names:
| Check | Meaning |
|---|---|
chokaq_sql | SQL Server reachable, а schema ChokaQ содержит required runtime tables. |
chokaq_worker | Hosted worker running, имеет capacity и недавно произвел process-local heartbeat. |
chokaq_queue_saturation | Worst pending queue lag находится внутри configured operational thresholds. |
Health.WorkerHeartbeatTimeout - максимальный age process-local heartbeat воркера. Это не то же самое, что per-job heartbeat storage: per-job heartbeats говорят zombie recovery, жив ли конкретный job; worker heartbeat говорит operators, жив ли сам hosted worker loop.
Health.QueueLagDegradedThreshold и Health.QueueLagUnhealthyThreshold отображают queue saturation в readiness status. Defaults совпадают с цветами дашборда The Deck: меньше пяти секунд - healthy, от пяти до десяти секунд - degraded, больше десяти секунд - unhealthy.
Зачем это нужно: queue depth сама по себе часто вводит в заблуждение. Queue с 10000 быстрых jobs может быть нормальной, а queue с 20 старыми jobs может означать, что worker застрял. Lag показывает, как долго реальная work ждет, и поэтому является более полезным operator signal для saturation.
Validation
ChokaQ валидирует configuration во время service registration. Invalid values останавливают application startup до того, как workers смогут claim real jobs.
Примеры rejected values:
- zero или negative execution timeout;
- zero retry attempts;
- retry max delay меньше retry base delay;
- heartbeat max interval меньше heartbeat min interval;
- zero in-memory capacity;
- empty SQL connection string;
- zero SQL polling interval;
- zero SQL command timeout;
- zero SQL cleanup batch size;
- zero или negative worker heartbeat timeout;
- queue lag unhealthy threshold меньше degraded threshold;
- zero metric tag cardinality budget;
- blank metric unknown или overflow tag value.
Fail-fast validation намеренная. Queue processor не должен обнаруживать invalid operational policy после того, как уже принял production work.
Архитектурное решение
Почему выбран такой pattern?
Runtime configuration управляет durability, retry, recovery, health, metrics и security posture. Fail-fast на startup безопаснее, чем позволить worker запуститься с invalid operational policy.
Trade-offs
Strict validation может отклонить host, который иначе смог бы стартовать. Для queue infrastructure bad config должен быть виден до того, как jobs будут claimed.
Рассмотренные альтернативы
| Alternative | Benefit | Cost |
|---|---|---|
| Silent defaults | Easy startup. | Hidden production mistakes. |
| Warn only | Flexible. | Workers may run with unsafe policy. |
| Validate at first use | Lazy. | Failures happen after jobs are accepted. |
Дополнительные вопросы
Почему config валидируется на startup?
Потому что retry, storage и dashboard policy должны быть корректны до того, как workers claim production work.
Какая configuration наиболее опасна?
Connection string, timeout, retry, heartbeat/zombie recovery и dashboard authorization settings.
Зачем разделять code registration и appsettings policy?
Code владеет compile-time contracts; configuration владеет environment-specific runtime behavior.